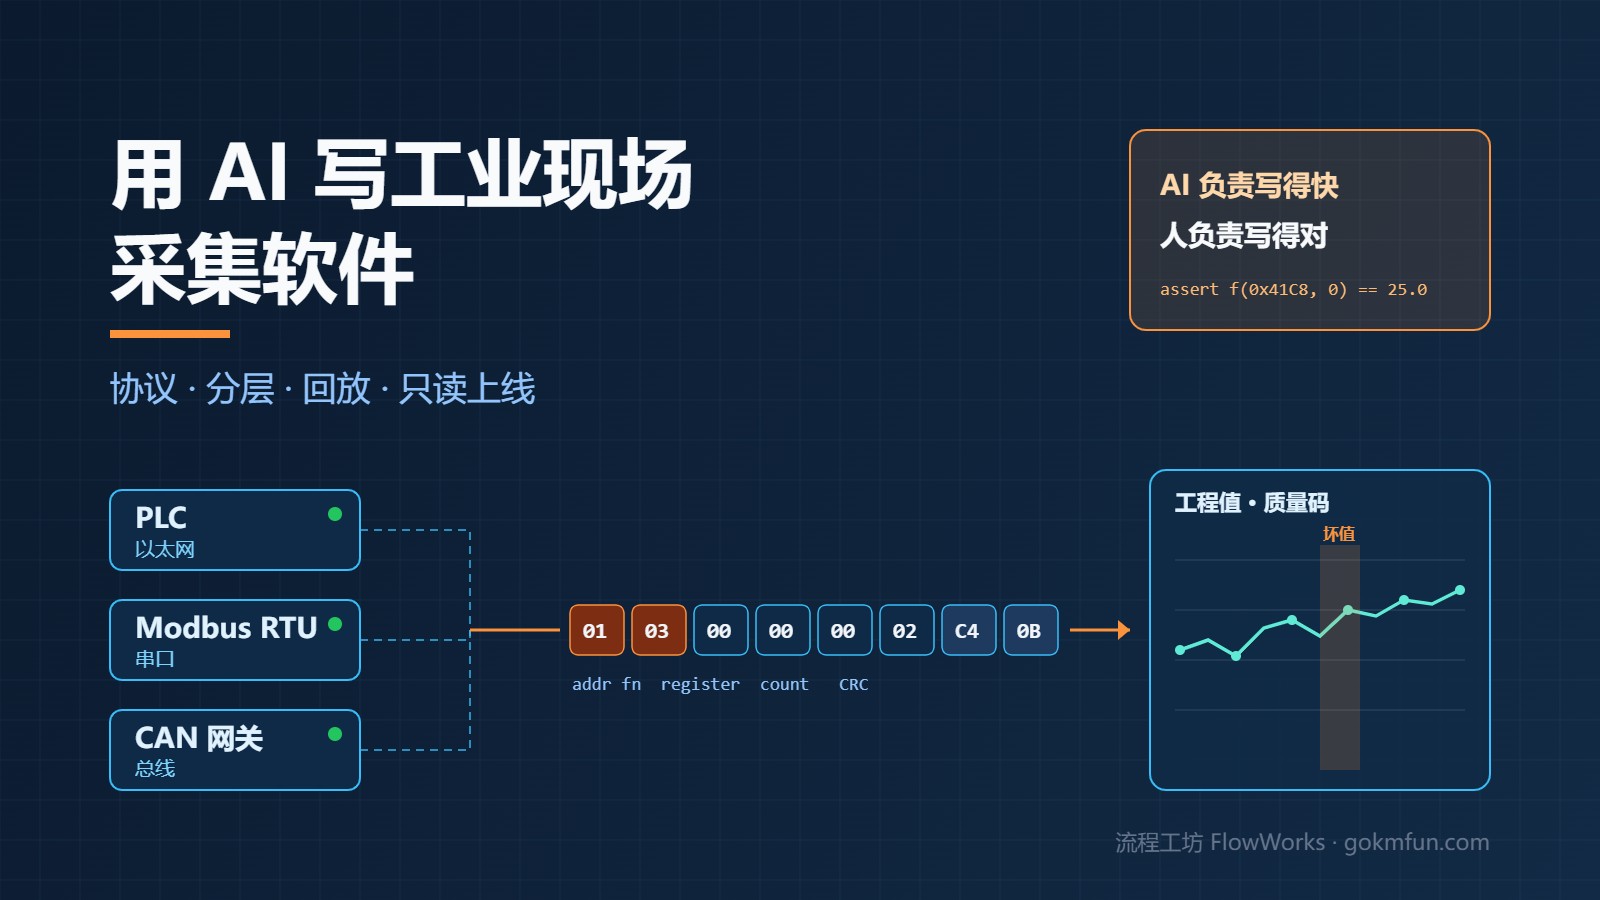
现场采集软件有个特点:需求不大,但每个都很碎。一台老设备只认 Modbus RTU,一台新 PLC 走以太网,网关又是另一家的私有协议;点表散落在 Excel、纸质图纸和老师傅的脑子里;而且现场不容错——采集程序挂了没人知道,数据断了一周才发现。
过去这类工具要么外包,要么一个小组慢慢磨。这两年我把大部分采集小工具交给 AI 写,自己负责“定义问题”和“验收”。效率确实上去了,但前提是方法对。下面是我反复踩坑后留下来的一套做法。
一、先把“现场”讲清楚,再让 AI 动手
AI 写代码很快,但它不知道你的现场。最常见的翻车,就是让它“写一个 Modbus 采集程序”,它会很自信地编出一套寄存器地址。
所以第一步不是写代码,而是把现场整理成 AI 能读的结构化材料:
- 设备清单:设备类型、通信方式(RTU / TCP / CAN / OPC UA)、IP 或串口参数、站号。
- 点表:点位名称、寄存器地址、数据类型、字节序、缩放系数、单位、读写属性。统一成一张 CSV,比十张截图有用得多。
- 协议手册摘录:只摘和本次相关的帧格式、功能码、异常码,不要整本丢进去。
- 验收样本:几条抓到的真实报文和它对应的正确数值。这一条最重要,它是后面所有测试的标准答案。
规则只有一条:地址和含义由人提供,AI 只负责实现。点表里没有的点,宁可空着,也不让 AI 猜。
二、分层,一次只让 AI 写一层
一个采集程序可以拆成四层:
- 通信层:建连、收发、超时、重连。
- 解析层:把字节流变成带单位的工程值。
- 存储层:写数据库或文件,处理缓存与补传。
- 展示层:界面、报表、告警推送。
每层之间用简单的数据结构约定接口,比如解析层只输出 {点位, 时间戳, 值, 质量码}。这样做有两个好处:AI 每次面对的上下文小,出错少;哪一层出问题,换掉那一层就行,不用推倒重来。
我的习惯是先让 AI 写解析层,因为它最容易用固定报文做单元测试;通信层最后写,因为它最依赖现场。
三、协议细节,AI 最容易错的几个地方
这些坑我几乎每个都遇到过,现在会在提示词里直接写明:
- 字节序和字序:32 位浮点占两个寄存器,有 ABCD、CDAB、BADC 等多种排列。AI 默认往往只写一种。
- 地址基准:手册里的 40001,到底对应协议地址 0 还是 1?差一位,读出来的全是邻居的数据。
- 数据类型:有符号还是无符号、是否带缩放系数、BCD 编码,都要在点表里写死。
- CAN 帧:标准帧和扩展帧的 ID 长度不同,多帧报文要按序重组。
- TCP 粘包和半包:一次
recv不等于一帧,必须按长度字段或帧尾切分。
对字节序这类问题,我会让 AI 先写一个很小的换算函数,用验收样本逐条核对,再接到主程序里:
import struct

def regs_to_float(hi, lo, word_swap=False):
    """两个 16 位寄存器 -> 32 位浮点。word_swap=True 对应 CDAB 排列。"""
    if word_swap:
        hi, lo = lo, hi
    return struct.unpack(">f", struct.pack(">HH", hi, lo))[0]

assert regs_to_float(0x41C8, 0x0000) == 25.0
assert regs_to_float(0x0000, 0x41C8, word_swap=True) == 25.0
这种小函数配上断言,AI 改十次也不怕,跑一遍测试就知道对不对。
四、用模拟器和回放代替现场调试
去现场调试成本很高:要协调停机窗口,要穿劳保,网络还可能是隔离的。我的做法是尽量把调试搬回办公室:
- 录制:在现场用抓包工具或串口监听,录一段真实通信。
- 回放:让 AI 写一个回放器,把录到的报文按原时序喂给采集程序。
- 模拟从站:让 AI 按点表写一个模拟设备,可以人为制造超时、断线、异常码。
这样大部分 bug 在办公室就能复现。等真正到现场时,要验证的只剩“线接对没有、参数配对没有”。
五、可靠性:AI 默认只写“开心路径”
AI 写出来的第一版,几乎都是“连上、读到、存好”的理想流程(通信层的通用要点,我在《上位机通信稳定性清单:以 CAN 总线为例》里整理过)。现场真正要命的是那些不开心的路径,需要逐条明确要求:
- 断线重连:指数退避,不要一断线就疯狂重试把设备打死。
- 看门狗:采集进程或网关挂了,要有独立的守护程序拉起来,并留下日志。
- 本地缓存与补传:数据库或网络中断时先落本地,恢复后按时间顺序补传。
- 时间戳:以采集端时间为准,并定期校时;不要等数据入库时再打时间。
- 质量码:读失败时写入“坏值”标记,而不是沿用上一个值——沿用旧值最隐蔽,也最危险。
我会把这几条做成一张固定清单,每次让 AI 写完代码后,再让它对照清单逐条自查,并指出代码里对应的位置。
六、上线:只读、旁路、可回滚
采集软件上线有几条硬规矩,和代码是谁写的无关:
- 默认只读:采集程序只用读功能码,数据库账号只给需要的表和权限。
- 旁路运行:新程序先和原有系统并行跑一段时间,逐点对比数值,一致了再切换。
- 分批启用:先接一两台设备,稳定后再扩到全部。
- 一键回滚:保留上一版程序和配置,出问题能在几分钟内退回去。
涉及写入和控制的逻辑,不交给 AI 自主完成。 AI 可以帮忙写代码,但每一个写操作的地址、取值范围、联锁条件,都必须由人确认并在现场验证。
七、AI 适合做什么,不适合做什么
用下来,我对分工的看法是这样的:
适合交给 AI 的:协议解析和换算、样板代码、配置界面、报表导出、日志和告警推送、单元测试和模拟器、把零散点表整理成统一格式。
必须自己把关的:点位的物理含义、地址和数据类型、安全联锁与控制逻辑、上线和切换的时机。
一句话总结:AI 负责“写得快”,人负责“写得对”。把现场知识结构化、把验收标准提前写好,AI 才能真正成为一个靠谱的帮手,而不是一个自信的猜测者。
附:每次开工前的检查清单
- ☐ 设备清单和通信参数已整理成表
- ☐ 点表包含地址、类型、字节序、系数、单位、读写属性
- ☐ 至少有几条真实报文作为验收样本
- ☐ 解析层有单元测试,模拟从站可用
- ☐ 断线重连、看门狗、缓存补传、质量码都有覆盖
- ☐ 上线方案:只读账号、旁路对比、分批启用、回滚步骤