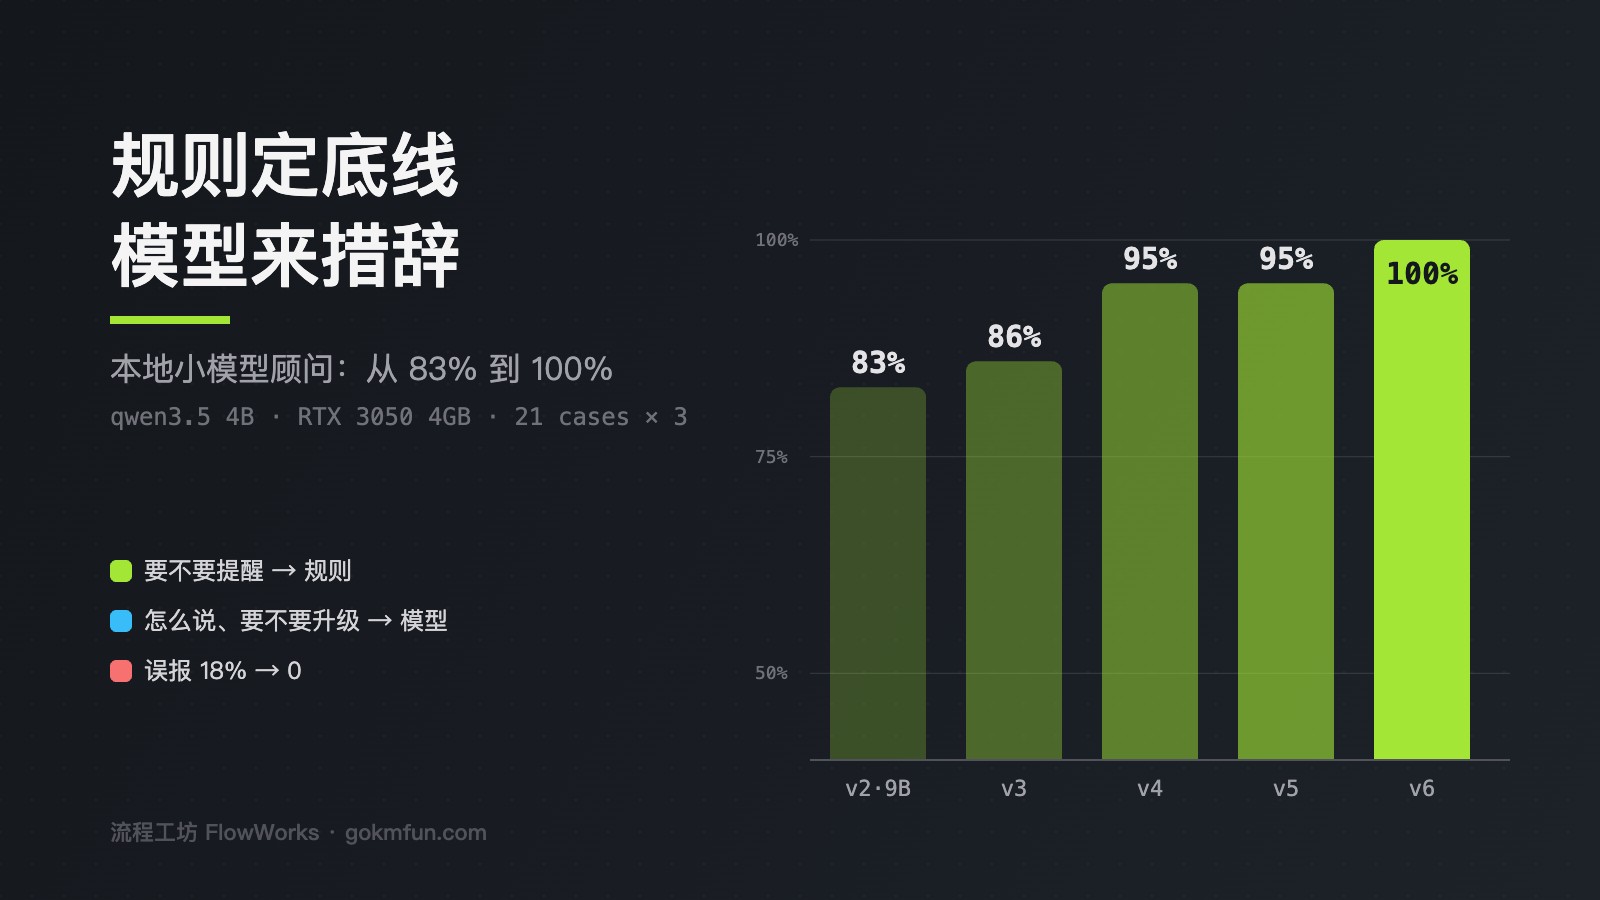
我的工作台上有一个“项目顾问”:每天晚上,本机的 Ollama 读一遍所有项目的状态、阶段、下一步和最后更新时间,判断哪些项目值得提醒我关注,把提醒推到工作台上,由我点“采纳”或“忽略”。家里的 Mac 跑 9B 模型,单位的笔记本只有一块 4GB 显存的 RTX 3050,只能跑 4B。
这篇记录它从第一版到第六版的过程。结论先放前面:小模型最不可靠的地方,恰恰是“该不该提醒”这个判断本身;把判断交给规则、让模型负责措辞以后,4B 模型也能稳定满分。
一、先有评测集,再谈调提示词
改提示词最怕“感觉变好了”。所以动手之前,我先写了一套固定用例:
- 种子用例:最初 18 个,后来补到 21 个。全部是虚构的通用项目,覆盖“正常推进”“已标记受阻”“已上线维护”“下一步写得含糊”“很久没动”等情况,每个用例写明期望的风险等级。
- 指标:提醒判断准确率、漏报率、误报率、等级命中、格式一次合格率、多次运行的一致性、平均耗时。
- 原则:误报比漏报更要紧。提醒一多,人就不看了,顾问也就没用了。
每次改提示词或换模型,跑一遍 --repeat 2,看数字说话。
二、第一版的问题:同一个提示词,两次结果不一样
第二版提示词(v2)在 Mac 上实测:
| 模型 | 准确率 | 漏报 | 误报 |
|---|---|---|---|
| qwen3.5 9B(第一轮) | 89% | 10% | 12% |
| qwen3.5 9B(第二轮) | 83% | 10% | 25% |
| qwen3.5 9B(第三轮) | 94% | 10% | 0% |
| gemma4 12B | 89% | 0% | 25% |
同一个模型、同一套用例,误报从 0% 到 25% 来回跳。换成 12B 的模型也没有本质改善。
再看错在哪里,几乎全是同一类:
- 规划阶段、下一步写得很具体的项目,被判成“需要关注”;
- 已上线、处于维护状态的项目,有时被判成“很久没动,要提醒”;
- 下一步只写了“继续优化”的项目,有时被判成“一切正常”。
还有一个真实场景里的噪音:两个刚建好、还没写进度文件的文件夹,被模型判成“信息严重缺失、数据异常,需立即核实”。
这些都不是“理解力不够”的问题,而是模型在做它不擅长的事:算日期、判断一句话算不算具体、记住“维护状态不用提醒”这种规则。
三、四步迭代:把确定的事情一件件拿走
v3:能用代码算的,不让模型算。 “距上次更新几天”由代码算好;“下一步是否笼统”也由代码判断——把“继续”“优化”“完善”“待定”“看情况”这类词去掉后什么都不剩,就算笼统。两个结论作为事实写进提示词。没有进度文件的项目不再交给模型。
v4:本人已知情的,不提醒。 已标记受阻的项目、下一步具体且 20 天内有更新的项目,直接由规则判为“不提醒”。4GB 显卡上的 4B 模型,误报从 18% 降到 0。
v5:下一步具体但很久没动,由规则提醒。 4B 模型连续几次把“25 天没动、但下一步写得很清楚”的项目判成正常,于是这一类也交给规则:超过 20 天提醒,超过 40 天升为重点。
v6:规则定底线,模型可以往上调。 最后一个错例是“下一步只写了'继续优化'”,模型这次判对、下次判错。于是改成:没写下一步或下一步笼统的项目,规则保证至少“中等风险”;模型可以把它升为“高风险”,并负责写提醒的具体措辞。核心逻辑只有几行(示意):
def rule_floor(project, today, stale_alert_days=40):
    nxt = (project.get("next_action") or "").strip()
    d = days_since(project.get("updated_at"), today)
    risk = "high" if (d is not None and d > stale_alert_days) else "medium"
    if not nxt or nxt in ("无", "-"):
        return risk, "还没写下一步:补一件具体、当天就能动手的事。"
    if next_is_vague(nxt):
        return risk, f"下一步只写了「{nxt[:16]}」,太笼统:改成一件具体的事。"
    return None

# 模型给出 low,但规则底线是 medium:以规则为准,模型的措辞保留
if floor and RISKS.index(model_risk) < RISKS.index(floor[0]):
    risk, note = floor[0], model_note or floor[1]
四、结果
4GB 显卡、qwen3.5 4B 模型上的变化:
| 版本 | 准确率 | 漏报 | 误报 | 由规则判定的用例 |
|---|---|---|---|---|
| v3 | 86% | 10% | 18% | 6 / 21 |
| v4 | 95% | 10% | 0% | 12 / 21 |
| v5 | 95% | 10% | 0% | 14 / 21 |
| v6 | 100% | 0% | 0% | 14 / 21(其余 7 个有底线) |
v6 每个用例连跑三次,准确率、等级命中、格式合格率都是 100%,平均每次 0.7 秒;三次结果完全一致的用例占 90%,不一致的只是在“中等”和“高”之间摆动,不影响要不要提醒。同一块显卡上的 2B 模型(v3 时测)漏报高达 70%,直接淘汰——小模型不是越小越好,4B 是这块卡上能用的下限。
真实运行时更省:单位电脑上 29 个项目,25 个由规则直接判定,4 个在冷却期内跳过,那天模型一次都没被调用,产生 0 条提醒——因为那些项目确实都在正常推进。
五、几条经验
- 能用代码算的,别让模型算。 日期差、一句话是否具体、某个状态是否属于“已完成”,代码几行就能写对,模型却会时对时错。
- “要不要提醒”交给规则,“怎么说”交给模型。 判断是否提醒需要稳定,措辞需要灵活,两件事分开以后各自都好办。模型还保留了“往上调”的权力,遇到规则没覆盖的严重情况可以升级。
- 评测集里要有真实的噪音。 最早的用例里没有“刚建好、还没写进度文件”的文件夹,结果线上第一天就被它刷了两条提醒。现在每次线上出现意外,都先补一个用例。
- 指标本身也要验证。 有一轮报告显示“格式合格率 71%”,排查后发现是把规则判定的用例也算进了分母——模型其实一次都没出错。数字不对劲时,先怀疑统计口径。
- 换更大的模型不是第一选择。 12B 的模型并没有解决问题;把确定的部分拿走以后,4B 就够了,而且能跑在一块 4GB 的笔记本显卡上。
六、代价和还没解决的事
规则多了,系统会变“硬”:以前我可以通过“忽略”让模型慢慢学会少提醒某类项目,现在“要不要提醒”主要由规则决定,这种学习能力变弱了,只能靠冷却期(同一项目处理过后 14 天内不再提醒)来缓冲。另外,种子用例都是虚构的,下一步要用真实的“采纳 / 忽略”记录生成用例,让评测集慢慢贴近我自己的习惯。
整体思路和我之前在《从零搭一个本地 Agent》里写的一致:本地小模型适合做“前哨”,前提是给它划好边界——边界越清楚,它越可靠。