工业现场的很多系统都跑在内网里:不能连外网,数据也不允许出厂。可真正好用的大模型都在云上。怎么让两边配合?这段时间我在琢磨一种分工:本地 Agent 当"前哨",云端大模型当"参谋"。
要点速览
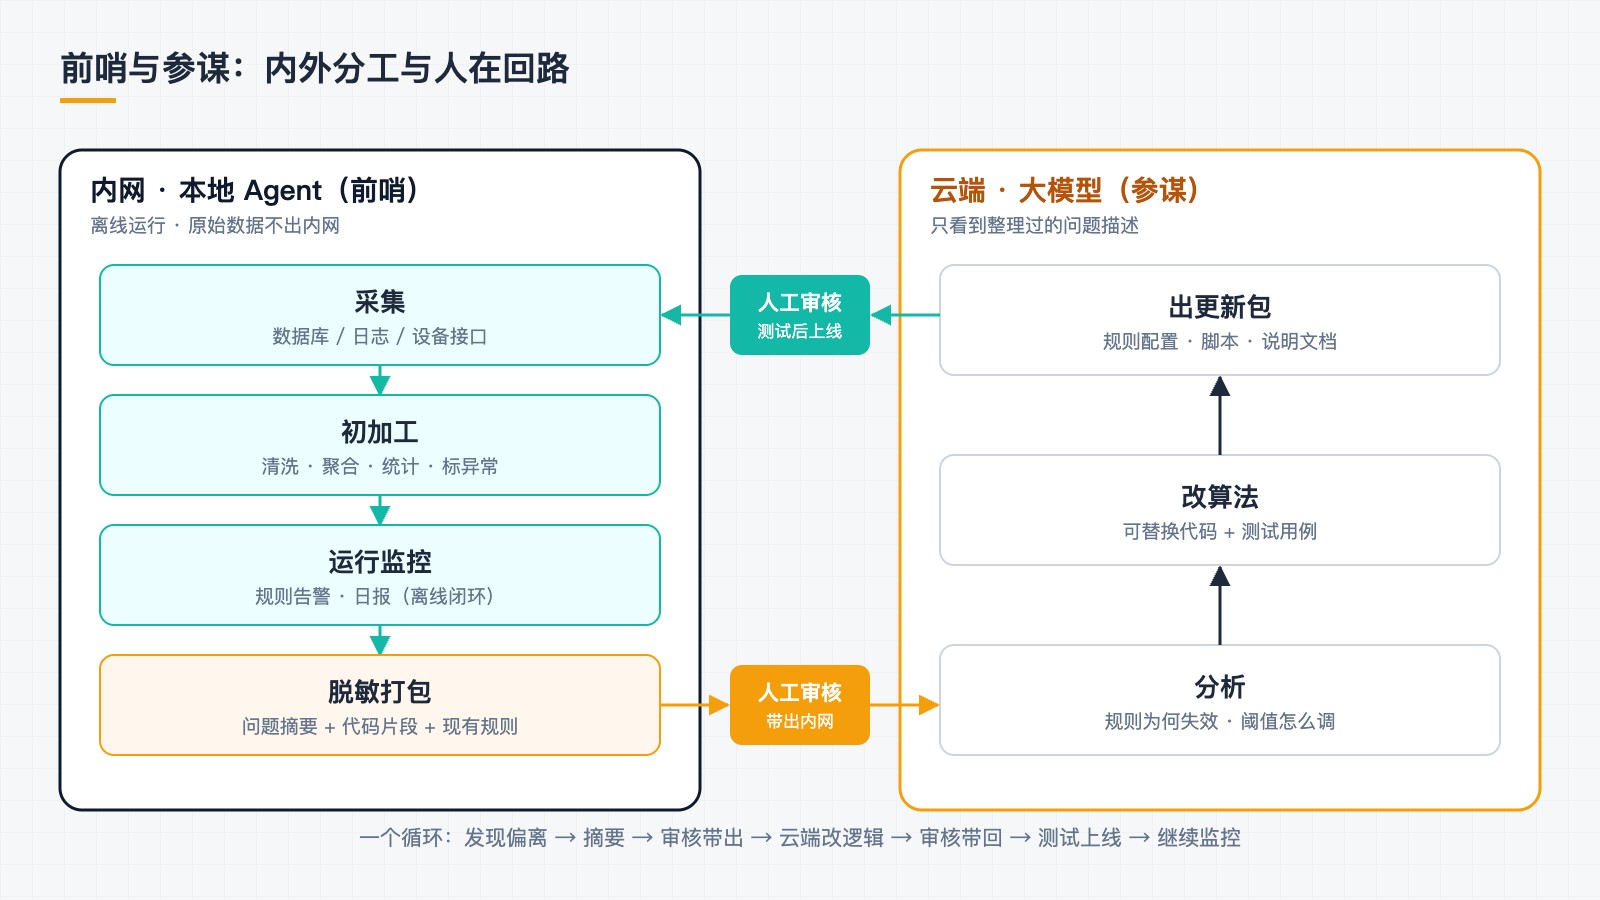
- 前哨(本地 Agent):采集、初加工、离线监控、脱敏打包。
- 参谋(云端大模型):分析原因、改算法、产出更新包。
- 内外交接两道人工审核,原始数据永不出内网。
- 先在一个系统试点,硬件需求随流程验证再定。
为什么不能只用一边
- 只用云端:内网系统根本连不上;就算能连,原始生产数据也不该外发。
- 只用本地:本地能跑的模型规模有限,做数据整理和规则判断够用,但要重新设计算法、重构复杂逻辑,能力明显不够。
所以思路是各干各擅长的事,中间用一份"干净的交接材料"连接起来。
前哨:本地 Agent 做什么
- 采集:定时从数据库、日志、设备接口拉数据。
- 初加工:清洗、聚合、算统计量,标出异常点和趋势变化。
- 运行监控:按现有规则做告警和日报,这部分完全离线闭环。
- 脱敏打包:把需要"动脑子"的问题整理成摘要——现象、统计特征、相关代码片段、现有规则——去掉敏感字段后导出。
参谋:云端大模型做什么
- 读摘要,分析规则为什么失效、阈值该怎么调。
- 重写或优化算法逻辑,给出可直接替换的代码和测试用例。
- 产出更新包:新的规则配置、脚本和说明文档。
原始数据从不离开内网,外面只看到经过整理的"问题描述"。
一个循环长什么样
- 本地 Agent 发现某项指标连续几天偏离预期,自动生成问题摘要。
- 工程师审一眼摘要,确认没有敏感信息,带出内网。
- 云端模型分析后给出修改后的计算逻辑和对应测试。
- 带回内网,在测试环境跑通,再替换到生产配置。
- 本地 Agent 继续监控,下一轮反馈效果。
几点设计原则
- 人在回路:Agent 不自动把东西送出去,也不自动上线改动。
- 配置优先:能用配置表达的逻辑不写死在代码里,云端给的更新多数只是改配置,风险小、好回滚。
- 先从一个系统做起:先在服务器数据管理系统上试点,跑顺了再推广。
- 硬件慢慢来:本地只做采集和初加工,对模型规模要求不高,先用现有机器验证流程,再决定是否采购算力。
这套东西还在搭建中,后面会把本地 Agent 的具体实现和踩过的坑陆续写出来。