现场的上位机程序,最怕的不是慢,而是"偶尔不对":半夜数据断了一段、某台设备状态卡住不刷新、重启就好。回头看,这类问题几乎都出在通信层的细节上。这篇以 CAN 总线为例,整理一份我自己在用的稳定性清单。
要点速览
- 接收和处理分开:接收线程只管收,放进缓冲区。
- 每个节点都有心跳和超时,状态要能"变灰"。
- 关注错误帧和 Bus-Off,恢复策略要提前设计。
- 原始报文落盘,出问题能回放。
一条好的接收链路长什么样
1. 接收和处理解耦
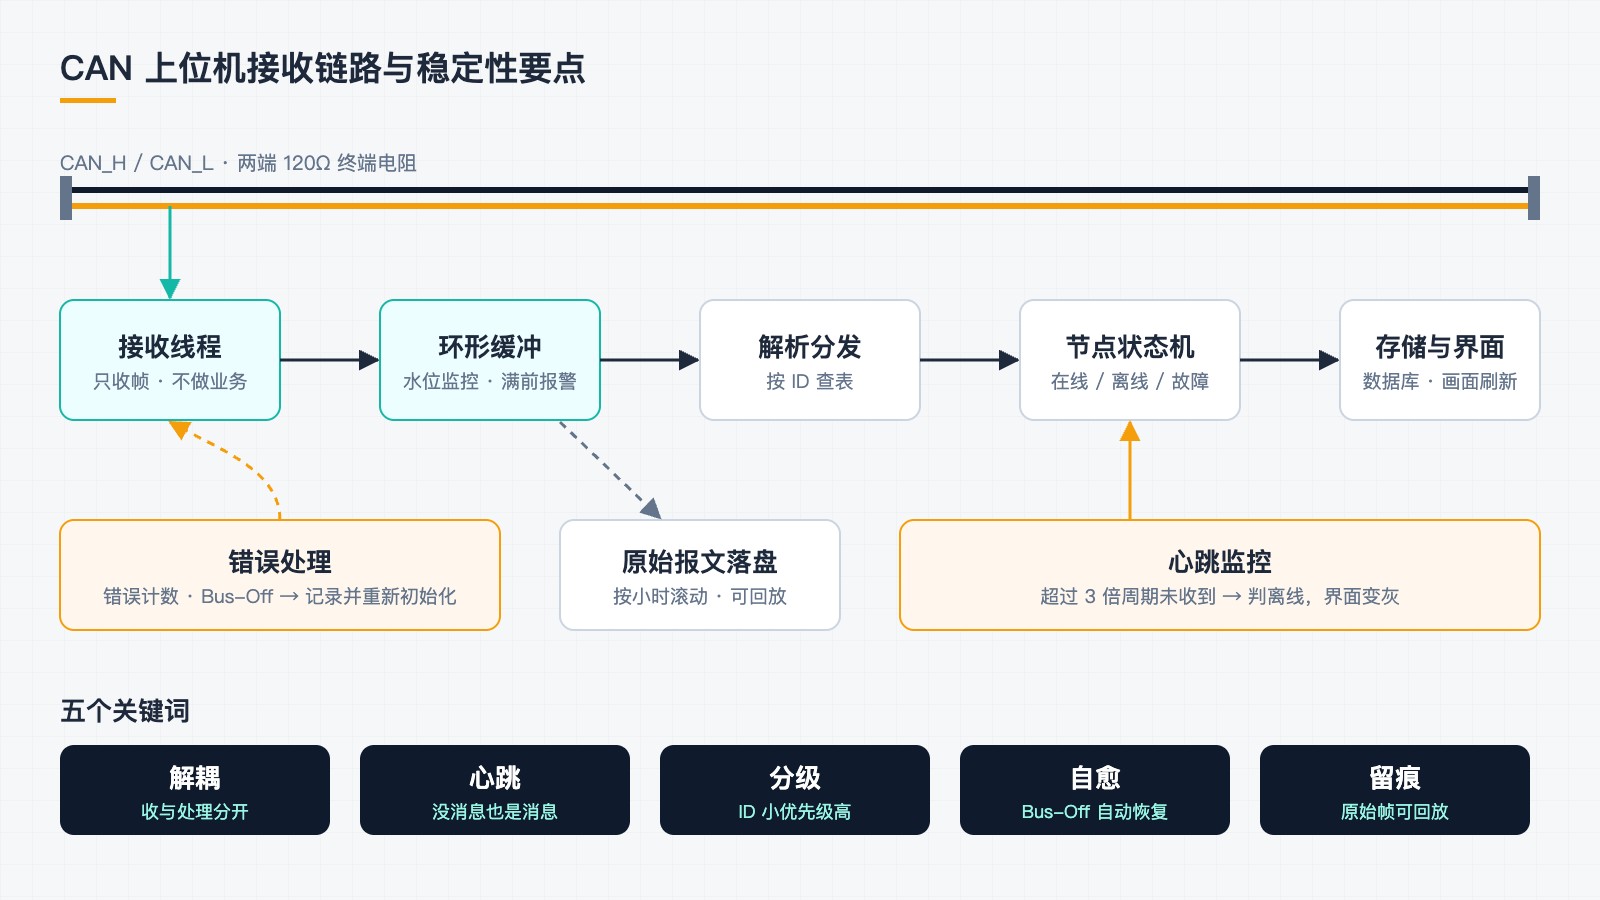
最常见的坑:在接收回调里直接解析、写数据库、刷界面。一旦某一步变慢,驱动缓冲区就会溢出,报文静悄悄地丢掉。正确做法是接收线程只做一件事——把原始帧放进环形缓冲区,由独立的处理线程慢慢消费。缓冲区要有水位监控,接近满时报警,而不是默默覆盖。
2. 心跳与超时:让"没消息"也成为消息
- 给每个节点记录"最后一次收到报文的时间"。
- 超过约定周期的若干倍(例如 3 倍)判定为离线,界面上立即变灰,而不是继续显示最后一个值。
- 离线和恢复都记日志,方便事后对时间线。
显示一个过期的正常值,比显示"离线"危险得多。
3. 帧 ID 规划
CAN 仲裁时 ID 数值越小优先级越高。报警、控制类报文分配小 ID,周期性的状态和统计数据分配大 ID。ID 里编码"报文类型 + 节点号",解析时查表分发,新增节点不用改代码。
4. 错误帧与 Bus-Off
CAN 控制器内部有发送、接收错误计数器。错误持续累积,节点会先进入被动错误状态,发送错误计数超过 255 后进入 Bus-Off,彻底停止收发。上位机要能读到这些状态并主动处理:记录、报警、按策略重新初始化通道,而不是等人去重启程序。
5. 物理层别忽视
- 总线两端各一个 120Ω 终端电阻,断电后用万用表量 CAN_H 与 CAN_L 之间应约为 60Ω。
- 长距离、强干扰环境用屏蔽双绞线,屏蔽层单点接地。
- 错误帧突然增多,先查线缆和接头,再查软件。
6. 原始报文落盘,出问题能回放
把原始帧(时间戳 + ID + 数据)按小时滚动写入文件,保留几天。现场出现"偶发"问题时,拿日志在测试环境回放,比猜测高效得多。这一步成本很低,却是排查疑难问题的最后一道保险。
这份清单不涉及具体协议细节,换成 Modbus、以太网通信也基本适用:解耦、心跳、分级、自愈、留痕。